หลายองค์กรอยากนำ AI และระบบวิเคราะห์ข้อมูลมาใช้ แต่ติดข้อจำกัดสำคัญคือข้อมูลจริงมีรายละเอียดส่วนบุคคล เปิดให้ทีมพัฒนาหรือคู่ค้าทดสอบได้ยาก และบางกรณีมีข้อมูลไม่มากพอครอบคลุมเหตุการณ์ที่ต้องการ Synthetic Data หรือข้อมูลสังเคราะห์จึงได้รับความสนใจ เพราะช่วยสร้างชุดข้อมูลจำลองที่มีโครงสร้างและรูปแบบใกล้เคียงของจริง โดยไม่จำเป็นต้องนำระเบียนของลูกค้ารายใดรายหนึ่งไปใช้ตรง ๆ
Synthetic Data คืออะไร
ข้อมูลสังเคราะห์คือข้อมูลที่สร้างขึ้นด้วยกฎทางสถิติ แบบจำลอง หรือระบบสร้างข้อมูล แทนการคัดลอกข้อมูลจริงมาใช้งาน ตัวอย่างเช่น ร้านค้าอาจสร้างประวัติคำสั่งซื้อจำลองที่มีช่วงราคา หมวดสินค้า และรูปแบบตามฤดูกาลคล้ายข้อมูลจริง หรือธนาคารอาจจำลองธุรกรรมหลายรูปแบบเพื่อทดสอบระบบตรวจจับความผิดปกติ จุดสำคัญคือระเบียนใหม่ควรเป็นบุคคลหรือเหตุการณ์สมมติ แต่ยังรักษาคุณสมบัติที่จำเป็นต่อการทดสอบ
ธุรกิจนำไปใช้กับงานใดได้บ้าง
กรณีแรกคือการพัฒนาซอฟต์แวร์ ทีมงานสามารถทดสอบหน้าจอ รายงาน และการรับภาระของระบบโดยไม่ดึงฐานลูกค้าจริงออกจากระบบหลัก กรณีที่สองคือการฝึกโมเดล AI เมื่อเหตุการณ์บางชนิดพบได้น้อย เช่น การทุจริตหรือความเสียหายเฉพาะแบบ ข้อมูลจำลองช่วยเพิ่มตัวอย่างสำหรับการทดลองได้ กรณีที่สามคือการแบ่งปันข้อมูลระหว่างแผนกหรือพันธมิตร โดยลดการเปิดเผยรายละเอียดที่ไม่จำเป็น และกรณีที่สี่คือการจำลองสถานการณ์เพื่อวางแผนกำลังผลิต สต็อก หรือบริการลูกค้า
ข้อมูลสังเคราะห์ไม่ได้แปลว่าปลอดภัยอัตโนมัติ
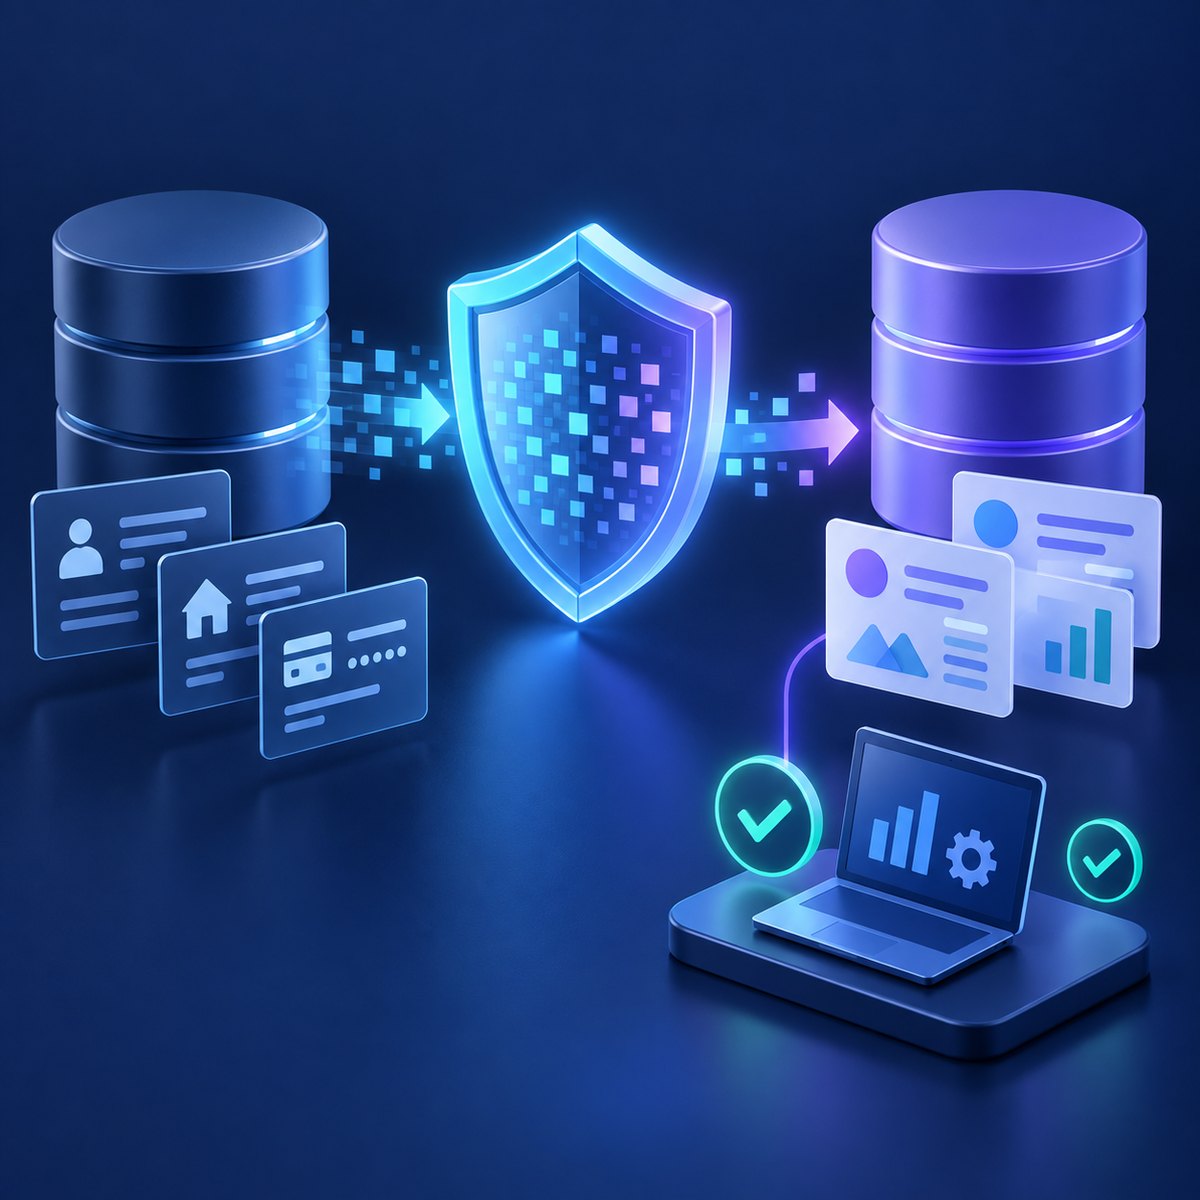
ข้อผิดพลาดที่พบบ่อยคือคิดว่าข้อมูลที่ระบบสร้างขึ้นไม่มีความเสี่ยงด้านความเป็นส่วนตัวเสมอ หากแบบจำลองจดจำข้อมูลต้นฉบับมากเกินไป มันอาจสร้างระเบียนที่คล้ายบุคคลจริง หรือเปิดช่องให้อนุมานข้อมูลสำคัญได้ อีกด้านหนึ่ง หากสังเคราะห์จนแตกต่างจากของจริงมากเกินไป ผลวิเคราะห์ก็อาจใช้ตัดสินใจไม่ได้ NIST อธิบายว่าข้อมูลสังเคราะห์ที่ใช้ Differential Privacy สามารถให้หลักประกันด้านความเป็นส่วนตัวที่วัดได้ แต่ข้อมูลสังเคราะห์ทั่วไปไม่ได้มีคุณสมบัตินี้โดยอัตโนมัติ
เริ่มต้นอย่างไรให้คุ้มค่า
เริ่มจากระบุวัตถุประสงค์ให้แคบ เช่น ใช้ทดสอบรายงานยอดขาย ไม่ใช่สร้างข้อมูลชุดเดียวสำหรับทุกงาน จากนั้นกำหนดคอลัมน์และความสัมพันธ์ที่ต้องรักษา เช่น ยอดซื้อเฉลี่ย ความถี่ หรือสัดส่วนลูกค้าแต่ละกลุ่ม แยกข้อมูลระบุตัวบุคคลออกตั้งแต่ต้น กำหนดผู้มีสิทธิ์เข้าถึง และสร้างเกณฑ์ตรวจคุณภาพทั้งด้านความแม่นยำ ความลำเอียง และความเสี่ยงต่อการระบุตัวกลับ ควรเปรียบเทียบผลจากข้อมูลจริงกับข้อมูลสังเคราะห์ในสภาพแวดล้อมควบคุมก่อนนำไปใช้จริง
ตัวชี้วัดที่ควรตรวจ
อย่าตรวจเพียงค่าเฉลี่ย เพราะข้อมูลอาจมีค่าเฉลี่ยใกล้กันแต่สูญเสียความสัมพันธ์ที่สำคัญ ควรดูการกระจายตัว ค่าผิดปกติ ความสัมพันธ์ระหว่างตัวแปร และผลลัพธ์ของงานปลายทาง เช่น โมเดลที่ฝึกด้วยข้อมูลสังเคราะห์ยังตรวจจับกลุ่มสำคัญได้หรือไม่ นอกจากนี้ต้องทดสอบความเป็นธรรมระหว่างกลุ่มและโอกาสที่ข้อมูลจะย้อนกลับไปคล้ายต้นฉบับมากเกินไป พร้อมบันทึกเวอร์ชัน วิธีสร้าง และข้อจำกัดให้ผู้ใช้งานเข้าใจ
สรุป
Synthetic Data ไม่ใช่ตัวแทนข้อมูลจริงสำหรับทุกกรณี แต่เป็นเครื่องมือที่มีประโยชน์เมื่อองค์กรต้องการพัฒนา ทดสอบ หรือทดลองโดยลดการสัมผัสข้อมูลสำคัญ ความสำเร็จขึ้นอยู่กับการกำหนดวัตถุประสงค์ การวัดคุณภาพ การจัดการความเสี่ยง และการกำกับดูแลที่ชัดเจน หากเริ่มจากโครงการเล็กที่มีผลลัพธ์วัดได้ ธุรกิจจะเรียนรู้ข้อจำกัดก่อนขยายไปสู่งาน AI ที่ซับซ้อนกว่า
แหล่งข้อมูล: NIST: Differentially Private Synthetic Data